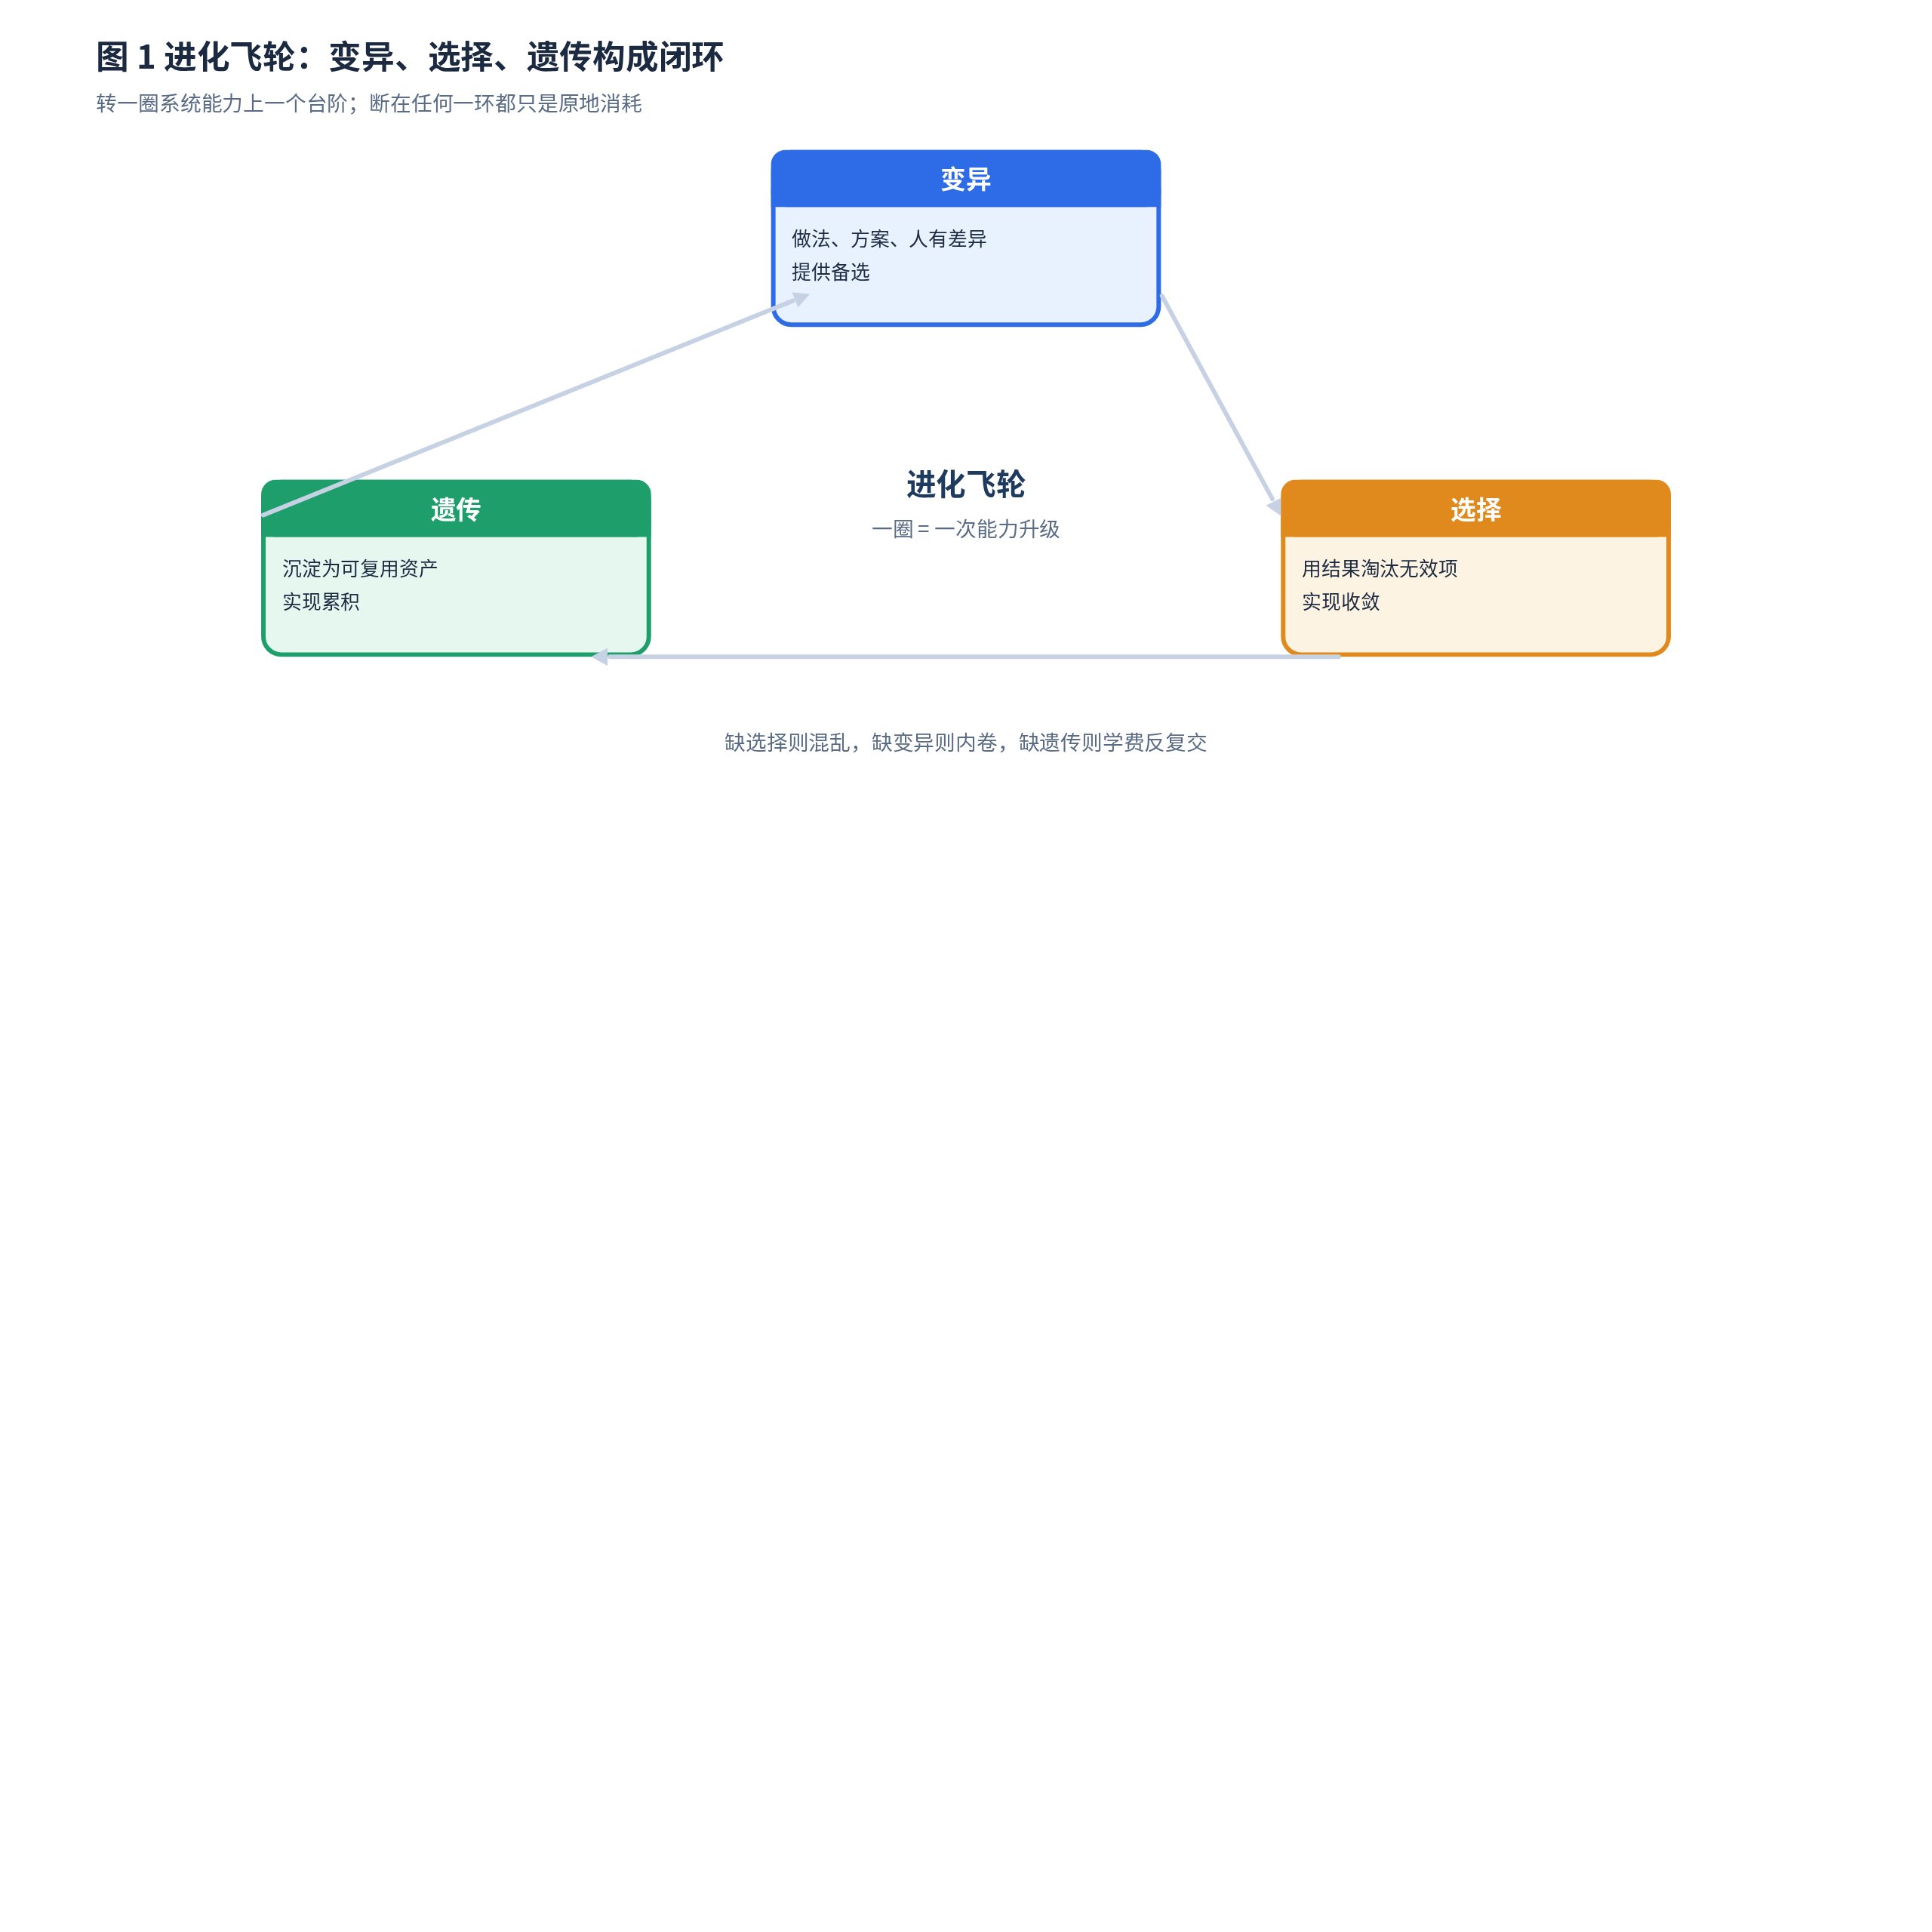
达尔文进化论的变异、遗传、选择三要素,可作为诊断组织适应力的通用框架。本文将其映射到团队管理、招人、业务与项目四个场景,指出组织进化慢的主因通常不是人的能力,而是经验未能沉淀为可传递的资产,并给出三个可调旋钮与一份落地检查清单。

把产品演进分成三段:定制交付、平台化、平台编排,分别对应「看山是山、看山不是山、看山还是山」。多数团队不是卡在第一重,而是停在第二重——抽象做得很整齐,却忘了回到使用者的视角。
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev——一个不生成文本、只做类型化决策的模型。它的创始人是 ChatGPT 的联合发明人,他说"ChatGPT 时代是一个奇怪的弯路"。
Agent 平台产品设计过程中存在一类高频偏差:产品经理沿用需求定义阶段的穷举方法,逐条罗列业务场景,并以此作为平台设计的输入。该方法在需求定义阶段具有合理性,但在平台构建阶段会带来三类系统性代价——覆盖不可完备、维护成本递增、缺乏结构信息。 本文提出一条从场景到能力的抽象路径:以动作结构统一场景描述,以动词收敛压缩场景空间,以契约属性划分能力边界,并以"新增场景是否零新增能力"作为抽象是否完成的验收标准。在此基础上,给出平台级场景的判定标准,包括平台级场景应具备的六项特征、不具备平台化价值的场景类型,以及打样场景的选择标准,并给出可对照判断的场景示例。文末给出 16 条典型偏差对照表与 5 项自检问题。
blockquote当 Skill 池膨胀到万级,模型上下文窗口装不下所有工具描述,"让 Agent 选对工具"就成了一个系统工程问题。本文梳理一套可落地的生产级方案——从 4 层漏斗架构、SkillRouter 论文实测数据、到置信度分流机制,完整走一遍。/blockquote hr / h2一、核心矛盾:1 万个 Skill,模型看不过来/h2 一个 MCP 工具的 schema 描述(名称 + 功能说明 + 参数定义)约 150 token。当 Skill 池达到 10,000 个,仅工具描述就需要约 150 万 token——远超当前主流模型的上下文窗口上限(128K–256K tokens)。 这不是"工具太多"的问题,而是strong"模型能看到的工具必须是经过筛选的子集"/strong的问题。我们需要一个分层漏斗,把 10,000 个候选逐步收窄到模型能处理的 5 个以内。 hr / h2二、系统全景:4 层漏斗 + 执行 + 反馈/h2 precode用户输入 ↓ ┌─────────────────────────────────────────────┐ │ Layer 1: 意图分类(规则引擎 + LLM 兜底) │ │ 10,000 → ~2,000 │ │ 延迟 <100ms │ └──────────────┬──────────────────────────────┘ ↓ ┌─────────────────────────────────────────────┐ │ Layer 2: 向量检索(SkillRouter Embedding) │ │ 2,000 → 20 │ │ 延迟 <50ms │ └──────────────┬──────────────────────────────┘ ↓ ┌─────────────────────────────────────────────┐ │ Layer 3: 精排(SkillRouter Reranker) │ │ 20 → 5 │ │ 延迟 <200ms │ └──────────────┬──────────────────────────────┘ ↓ ┌─────────────────────────────────────────────┐ │ Layer 4: LLM 最终选择 │ │ 5 → 1 │ │ 延迟 <500ms │ └──────────────┬──────────────────────────────┘ ↓ ┌─────────────────────────────────────────────┐ │ Layer 5: Skill 加载 + 执行 │ │ OpenViking 三层加载 → CubeSandbox/本地执行 │ │ 延迟 <1s │ └──────────────┬──────────────────────────────┘ ↓ ┌─────────────────────────────────────────────┐ │ Layer 6: 反馈闭环 │ │ 用户确认/纠正 → 训练集 → 定期重训模型 │ └─────────────────────────────────────────────┘ /code/pre 设计思路借鉴了业界头部玩家的共识——阿里千问的 strongNacos MCP Router 语义检索/strong和字节豆包的 strongCoze 三层渐进加载(详见附录)。核心原则一致:模型永远不直接面对全量工具,路由层做筛选,执行层做隔离/strong。 hr / h2三、各层详解:从论文数据到工程选型/h2 h3Layer 1:意图分类——先缩小战场/h3 strong职责/strong:把 10,000 个 Skill 按领域缩小到约 2,000 个候选。 strong分类体系/strong: table thead tr th领域/th thSkill 数量/th th典型关键词/th /tr /thead tbody tr tddata-reporting/td td2,000/td td报表、数据、分析、导出/td /tr tr tdcode-generation/td td2,500/td td代码、函数、测试、重构/td /tr tr tddocument-writing/td td1,500/td td写作、翻译、排版/td /tr tr tddevops/td td1,500/td td部署、监控、运维/td /tr tr tdcommunication/td td1,000/td td邮件、消息、通知/td /tr tr tdfile-management/td td800/td td文件、格式、转换/td /tr tr tdother/td td700/td td兜底/td /tr /tbody /table strong实现/strong:规则引擎优先(关键词 + 正则),置信度低于阈值时降级为 LLM 分类。延迟控制在 100ms 以内。 strong容错设计/strong:分类错误不影响最终结果——Layer 2 的向量检索会跨领域召回,分类只是缩小范围的加速手段。 hr / h3Layer 2:向量检索——用 SkillRouter Embedding 粗筛/h3 strong职责/strong:从约 2,000 个候选中检索 Top 20。 strong组件/strong:SkillRouter Embedding 0.6B + FAISS 向量库。 strong关键设计决策/strong: strong1. 用 SKILL.md 全文做 embedding,不是只有 description。/strong 这是最重要的工程决策。SkillRouter…
h1SKILL.md 撰写最佳实践/h1 p基于 Agent Skills 官方标准 (a href="https://agentskills.io/specification"agentskills.io/specification/a)/p blockquote p兼容:Claude Code / OpenClaw / Cursor / Gemini CLI / Codex CLI/p /blockquote hr / h2一、目录结构/h2 precodeskill-name/ ← 目录名必须和 name 字段一致 ├── SKILL.md ← 必须有:元数据 + 指令 ├── scripts/ ← 可选:可执行脚本(Python/Bash/JS) ├── references/ ← 可选:详细文档(按需加载) └── assets/ ← 可选:模板、图片、数据文件 /code/pre hr / h2二、SKILL.md 标准格式/h2 h3Frontmatter 字段定义/h3 table thead tr th字段/th th必填/th th约束/th th说明/th /tr /thead tbody tr tdname/td td✅/td td1-64字符,小写+数字+连字符/td td必须和目录名一致/td /tr tr tddescription/td td✅/td td1-1024字符/td td做什么 + 什么时候用/td /tr tr tdlicense/td td否/td td任意/td td许可证名称/td /tr tr tdcompatibility/td td否/td td1-500字符/td td环境依赖说明/td /tr tr tdmetadata/td td否/td tdkey-value map/td td自定义扩展字段/td /tr tr tdallowed-tools/td td否/td td空格分隔的工具名/td td预批准工具(实验性)/td /tr /tbody /table h3完整示例/h3 precode--- # ===== 必填字段 ===== # name: Skill 唯一标识 # 约束:1-64字符,仅允许 a-z、0-9、- # 不能以 - 开头或结尾,不能有 -- # 必须与父目录名一致 name: sales-report-generator # description: 做什么 + 什么时候用(两个都要写) # 约束:1-1024字符,不能为空 # 这是 Agent 判断是否调用此 Skill 的唯一依据 # 坏例子:"Helps with PDFs." description: 生成销售月报/周报/日报,支持按部门、产品线、区域维度汇总。 当用户提到"销售报表"、"销售数据"、"月报"、"业绩"时使用。 支持导出为 Excel 和 PDF 两种格式。 # ===== 可选字段 ===== # license: 许可证 license: Apache-2.0 # compatibility: 环境依赖要求(仅在有特殊要求时才写) compatibility: Requires Python 3.11+ and openpyxl # metadata: 自定义扩展字段(key-value) metadata: author: xiaoping version: "1.2.0" category: data-reporting last-updated: "2026-08-25" # allowed-tools: 预批准工具列表(实验性) allowed-tools: Bash(python:*) Read Write --- /code/pre h3name 字段规则/h3 table thead tr th合法/th th非法/th /tr /thead tbody tr tdpdf-processing/td tdPDF-Processing(大写)/td /tr tr tddata-analysis/td td-pdf(连字符开头)/td /tr tr tdcode-review/td tdpdf--processing(连续连字符)/td /tr /tbody /table h3description 字段要点/h3 ul li必须包含"什么时候用",不只是"做什么"/li li包含具体关键词帮助 Agent 匹配/li li好例子:"从 PDF 中提取文本和表格,填写表单,合并文件。当用户提到 PDF、文档提取、表单填写时使用。"/li li坏例子:"Helps with PDFs."/li /ul hr / h2三、Body 内容最佳实践/h2 h3建议包含的章节/h3 precode ## 什么时候用 明确列出触发场景 ## 什么时候不用 列出边界情况,避免误触发 ## 工作步骤 分步骤写清楚执行流程 ## 常见边缘情况 用表格列出异常情况的处理方式 ## 约束与安全 明确安全边界和限制 /code/pre h3Body 完整示例/h3 precode ## 什么时候用 用户提到以下场景时激活此 Skill:…
h2写在前面:为什么 MCP 不是一个技术标准,而是一次架构范式转移/h2p2024年底,Anthropic 推出了 Model Context Protocol(MCP),一个看似轻量级却暗藏巨大野心的开放协议。当我第一次深入阅读 MCP 的规范文档时,感受到的不是又一个 API 标准的诞生,而是一种与 REST、GraphQL 一脉相承的架构思维进化——只是这一次,主角从人机交互变成了 AI-系统交互。/pp如果说 REST 解决了 Web 服务的资源表述问题,GraphQL 解决了查询灵活性问题,那么 MCP 要回答的是:大语言模型如何安全、可控、标准化地与现实世界的工具和数据建立连接?/pp这篇文章不想做成 MCP 文档的中文翻译。我希望以技术和产品的双重视角,和你一起拆解 MCP 的架构设计逻辑、背后的取舍权衡、以及在实际落地中真正值得关注的坑与路。/phr/h2第一章:理解 MCP 之前,先理解那个被忽视的问题/h2h31.1 AI 集成的「巴别塔困境」/h3p在 MCP 出现之前,每一个想要让 LLM 接入数据的开发者都活在同样的噩梦里。/pp假设你要构建一个 AI 编程助手,它需要读取代码仓库、查询 Jira 工单、搜索内部文档、调用编译命令。在传统模式下,你需要:/pulli为代码仓库写一个文件读取模块/lili为 Jira 写一个 REST API 客户端/lili为内部知识库对接一个搜索 SDK/lili为 shell 命令写一个安全执行沙箱/li/ulp每个模块的认证方式不同、错误处理不同、数据格式不同。更致命的是,如果某个数据源换了个 API 版本,你的 AI 应用也得跟着变。这种耦合的本质问题是:strongAI 应用的逻辑和它所依赖的外部上下文之间没有清晰的边界。/strong/pp这就像在巴别塔建造中,每个工匠都在用各自的语言——最后塔没建成,只留下一堆互不兼容的胶水代码。/ph31.2 从「应用为王」到「上下文为王」/h3p传统软件架构中,应用是中心。数据库、文件系统、第三方 API 都是围绕应用来设计的。但在 AI 时代,这个假设被颠覆了——LLM 是一个「通用推理引擎」,它需要的是灵活的上下文注入,而不是僵硬的接口绑定。/ppMCP 背后的核心洞察是:strongAI 应用不应该知道数据的来源和细节,它只需要知道「我能调用什么工具」和「我能获取什么资源」。/strong 这是一个从「实现耦合」到「协议解耦」的跳跃,与 Unix 哲学中「一切皆文件」的思路如出一辙——只是在 AI 时代,变成了一切皆上下文。/ph31.3 MCP 的三大设计约束/h3p理解 MCP 的设计,必须理解它给自己设定的三大约束:/ppstrong第一,用户控制优先。/strong MCP 的所有交互都设计为让用户处于控制地位。工具调用可以被拦截和审批,资源访问需要用户授权,采样请求需要用户确认。这不是为了麻烦,而是为了信任——没有用户信任的 AI 系统,再强大也无法落地。/ppstrong第二,传输无关性。/strong MCP 的消息格式是 JSON-RPC 2.0,但传输层可以自由替换。stdio 适合本地进程通信,SSE 适合远程调用,未来甚至可以有 WebSocket、gRPC 等实现。这种分层设计让 MCP 可以适应从嵌入式设备到云端集群的各种场景。/ppstrong第三,能力协商。/strong 客户端和服务端在连接初始化阶段就通过能力协商明确各自支持的功能——我支持工具调用,你支持资源订阅——然后双方在达成一致的能力边界内交互。这避免了版本地狱,也为协议的未来演进留下了空间。/phr/h2第二章:架构拆解——MCP 的四个核心原语/h2pMCP 定义了四个核心原语:资源(Resources)、工具(Tools)、提示词(Prompts)、采样(Sampling)。理解这四个原语的本质差异和设计哲学,是掌握 MCP 的关键。/ph32.1 资源:数据世界的「文件系统」/h3p资源是 MCP 中最直观的概念——服务器暴露给客户端的数据。它可以是文件内容、数据库记录、API 响应、系统日志,甚至是一张截图。/pp资源的 URI 设计值得玩味。MCP 没有规定死 URI 的格式,而是留下了一个灵活的命名空间:codeprotocol://host/path/code。这意味着资源不仅仅是文件系统路径,它可以指代任意抽象的数据实体。例如:/pullicodefile:///home/user/project/main.py/code/lilicodepostgres://database/customers/schema/code/lilicodescreen://localhost/display1/code/li/ulp这种设计借鉴了 Web 的 URI 统一性,但更开放——每个 MCP 服务器都可以定义自己的 URI Scheme。关键在于,资源的 URI 要让 LLM 能够理解它的语义层级和归属关系。/pp资源的「应用程序控制」设计也是一个深思熟虑的决定。与工具不同,资源不是被 LLM 主动调用的,而是被客户端应用呈现给用户的。用户来决定是否以及何时将某个资源作为上下文提供给 LLM。这种设计降低了提示注入的风险——LLM 不会因为一个恶意的 prompt 就主动去读取敏感数据。/pp资源模板和订阅机制是容易被忽略但极其重要的特性。资源模板(RFC 6570 URI Template)允许服务器声明「我可以通过这种模式访问大量资源」,而不必预先生成所有资源的列表。订阅机制则让客户端可以监听资源的动态变化——这在实时监控、日志跟踪等场景中至关重要。/ph32.2 工具:LLM 的「双手」/h3p如果说资源是 LLM 的眼睛——用来观察世界,那么工具就是 LLM 的双手——用来改变世界。/pp工具的设计哲学与资源截然相反。工具是模型控制的(Model-Controlled),这意味着 LLM 可以在推理过程中主动决定调用哪些工具。这看起来简单,其实是 LLM 从「对话式 AI」走向「行动式 AI」的关键一步。/pp一个 MCP 工具的定义包含三个要素:/pullistrong名称/strong:唯一标识符,LLM 通过名称来引用工具/lilistrong描述/strong:人类可读的自然语言说明,这是给 LLM 看的核心文档/lilistrong输入 Schema/strong:基于 JSON Schema 的参数定义,严格约束了工具的输入/li/ulp为什么描述如此重要?因为 MCP 世界中的「用户」不仅仅是人类,还有 LLM。一个工具的描述就是 LLM 的 API 文档——写得清晰与否直接决定了 LLM 能否正确调用它。/ppAnthropic 的推荐实践是:在工具描述中嵌入使用示例。例如:/pprecode"获取特定股票的当前价格和近期走势数据。" "入参 symbol 为股票代码,例如'AAPL'代表苹果公司。" "调用示例:get_stock_price(symbol='TSLA') 返回特斯拉当前股价。"/code/prep这种「为 LLM 设计 API」的思维方式与传统的 API 文档完全不同。传统 API 文档面向的是人类的开发者,而 MCP 工具描述面向的是 LLM——它需要是确定的、无歧义的、自包含的。/pp工具调用的错误处理同样别具匠心。MCP 明确建议:工具层面的错误应当在结果对象内报告(通过 codeisError/code 标记),而不是作为 JSON-RPC 协议级错误抛出。为什么?因为当工具调用失败时,LLM 可以看到错误信息,并自主决定下一步动作——重试、换一种参数、或者通知用户。如果直接抛出协议级错误,LLM 就失去了纠错的机会。/ph32.3 提示词:可复用的「交互模式」/h3p提示词是我认为 MCP 中最被低估的能力。本质上,提示词是一组预定义的模板化对话——可以是单条消息,也可以是多轮交互的工作流。/pp提示词的存在揭示了 MCP 对 LLM 交互模式的一个深刻理解:strong大量有价值的 LLM 交互是模式化的,而非即兴的。/strong/pp想想日常使用场景:「总结这份代码」「分析这段日志」「对比两个版本的区别」——这些都是重复出现的交互模式。如果每个开发者都去自己写 prompt,不仅效率低下,还质量参差不齐。/ppMCP 的提示词机制让服务器可以暴露出这些经过精心设计的交互模板,客户端可以将其呈现为斜杠命令、快速操作、上下文菜单项等 UX 形态。这不是简单的 prompt 共享——它是一个生态级的交互标准化基础。/pp提示词天然支持动态参数和资源嵌入。一个分析代码的提示词可以接受 codelanguage/code 和 codefileUri/code 参数,然后在生成对话时自动嵌入对应文件的内容。这让提示词不再是死板的模板,而是可以感知上下文的智能交互入口。/ph32.4 采样:一次危险的「递归」/h3p采样是 MCP 中最具争议但也最具潜力的原语。它的核心思想是:strong让 MCP 服务器可以向客户端请求 LLM 生成内容。/strong/pp这听起来有点绕——LLM 让 AI 应用去请求 LLM 生成内容?是的,这是一种递归式的能力。想象一个复杂的代理工作流:主 LLM 在处理一个任务时,发现需要另一个 LLM 帮忙分析一段代码——它可以通过 MCP 的采样机制向客户端发起请求,客户端再向另一个 LLM 采样补全结果。/pp采样的关键在于「人在环路」(Human-in-the-Loop)设计。MCP 要求客户端在向 LLM 发送采样请求之前,必须先展示给用户查看和修改的机会;在收到补全结果之后,也要展示给用户确认。这意味着采样不是一个黑盒递归,而是一个受控的、可审计的协作过程。/pp模型偏好(Model Preferences)是采样中的一个精致设计。服务器可以表达对成本、速度、智能的三个维度的优先级(0-1),客户端根据自己的可用模型和这些偏好来做出最终选择。这为未来的多模型协同场景铺平了道路——想象一个系统,用便宜的小模型做预处理,用昂贵的大模型做核心推理,MCP 的采样机制天然支持这种编排。/pp不过坦率地说,采样目前在 Claude Desktop 中尚未支持,这意味它的实际生态验证还在早期。采样虽然理论上强大,但生产级的安全性验证仍需时日。/phr/h2第三章:传输层——从本地到全球的连接选择/h2h33.1 stdio:最简单的往往就是最好的/h3pMCP 的 stdio 传输非常简单:客户端启动一个子进程,通过标准输入发送 JSON-RPC 消息,从标准输出读取响应。服务端的标准错误则被用于日志输出。/pp这种设计看起来很朴素,但它解决了一个极其重要的问题——strong进程隔离与安全隔离/strong。MCP 服务器运行在独立的进程中,拥有自己的文件系统访问权限、网络栈、和生命周期。即使某个 MCP 服务器被攻破,攻击者也无法直接访问宿主应用的内存空间或其他 MCP 服务器的数据。/pp这也是为什么 stdio 被推荐用于本地场景——它天然提供了操作系统级别的隔离,不需要额外的容器化或沙箱化。/ph33.2 SSE:通往远程世界的桥梁/h3p当 MCP 服务器不在同一台机器上时,就需要网络传输。MCP 选择了 SSE(Server-Sent Events)作为标准远程传输方案。/ppSSE 的选择耐人寻味。为什么不是 WebSocket?为什么不是 gRPC?这背后是 MCP 的通信模式决定的:/pulliMCP 的核心交互是「客户端发起请求,服务端返回响应」/liliJSON-RPC 本身就是 request-response 模式/liliSSE 天然适合服务端到客户端的单向推送,而 HTTP POST 则处理反向通信/li/ulp这种组合的优势在于简单、兼容性好。SSE 可以跑在任何标准 HTTP 基础设施上——负载均衡器、反向代理、CDN——都不需要特殊配置。WebSocket 虽然双向通信更优雅,但在企业网络中经常被代理和防火墙阻断。/pp当然,SSE 也有局限。它的单向性意味着服务端不能主动发起请求(至少在标准 SSE 中不能)。目前 MCP 的 SSE 实现中,客户端到服务端的消息通过独立的 HTTP…
div class="eb-card eb-simple" div class="eb-card-bgbox"/div div class="eb-card-body" div class="eb-titlebox" span class="eb-titicon"svg xmlns="http://www.w3.org/2000/svg" width="16" height="16" fill="currentColor" class="xh-svg" viewBox="0 0 16 16"path d="M7.657 6.247c.11-.33.576-.33.686 0l.645 1.937a2.89 2.89 0 0 0 1.829 1.828l1.936.645c.33.11.33.576 0 .686l-1.937.645a2.89 2.89 0 0 0-1.828 1.829l-.645 1.936a.361.361 0 0 1-.686 0l-.645-1.937a2.89 2.89 0 0 0-1.828-1.828l-1.937-.645a.361.361 0 0 1 0-.686l1.937-.645a2.89 2.89 0 0 0 1.828-1.828l.645-1.937zM3.794 1.148a.217.217 0 0 1 .412 0l.387 1.162c.173.518.579.924 1.097 1.097l1.162.387a.217.217 0 0 1 0 .412l-1.162.387A1.734 1.734 0 0 0 4.593 5.69l-.387 1.162a.217.217 0 0 1-.412 0L3.407 5.69A1.734 1.734 0 0 0 2.31 4.593l-1.162-.387a.217.217 0 0 1 0-.412l1.162-.387A1.734 1.734 0 0 0 3.407 2.31l.387-1.162zM10.863.099a.145.145 0 0 1 .274 0l.258.774c.115.346.386.617.732.732l.774.258a.145.145 0 0 1 0 .274l-.774.258a1.156 1.156 0 0 0-.732.732l-.258.774a.145.145 0 0 1-.274 0l-.258-.774a1.156 1.156 0 0 0-.732-.732L9.1 2.137a.145.145 0 0 1 0-.274l.774-.258c.346-.115.617-.386.732-.732L10.863.1z"//svg/span span class="eb-title"智能摘要/span span class="eb-icon"svg t="1742538455943" class="xh-svg" viewBox="0 0 1024 1024" version="1.1" xmlns="http://www.w3.org/2000/svg" p-id="71517" width="24" height="24"path d="M554.144375 443.52552083L655.7121875 53.33333333 200 559.25333333l237.6478125 55.68-101.52 390.24 455.664375-505.96875z" p-id="71518" fill="currentColor"/path/svg/span /div div class="eb-excerpt"本文全面梳理 LLM 模型路由系统的技术原理与工业实践。核心探讨五大技术路线:规则路由、分类器路由、级联推理、强化学习路由与生成式路由,每一条均有 FrugalGPT、RouteLLM 等顶会论文论证。详细对比火山引擎 Auto Mode 与 OpenRouter 两种代表性的跨模型/跨供应商路由方案,给出分层路由 + 质量-成本联合优化的最佳实践架构。/div div class="eb-desc"span— 此摘要由AI生成仅供参考。/span/div /div /div h1LLM 模型路由系统深度调研:原理、论文与工业实践/h1 h2一、概述/h2 p随着大语言模型(LLM)的数量和种类爆发式增长,如何自动选择最合适的模型来处理用户请求,已成为 AI 基础设施的核心问题。模型路由系统(Model Routing System / LLM Gateway Router)应运而生,它充当用户请求与后端模型之间的智能调度层,在保证服务质量的前提下,优化成本、延迟与可用性。/p p本报告系统梳理模型路由系统的技术原理、核心要素、学术进展与工业界最佳实践。/p h2二、核心问题定义/h2 p模型路由问题可以形式化描述为:给定用户请求 codeq/code 和候选模型集合 codeM = {m₁, m₂, ..., mₙ}/code,路由系统需要选择最优模型 codem*/code,使得综合效用函数 codeU(q, m)/code 最大化:/p pstrongm* = argmax_{m ∈ M} U(q, m)/strong/p p其中 U 综合考虑任务匹配度、延迟、成本、可用性等多个维度。/p h2三、决策要素与评估维度/h2 h3任务类型与模型能力匹配/h3 p不同模型在不同任务上表现差异显著。代码生成任务中 DeepSeek Coder、GLM-4 表现优异;长文本推理场景下 Kimi 的 128K 上下文窗口优势明显;简单对话场景则轻量模型即可胜任。路由系统需对用户请求进行任务分类(Classification)。/p h3延迟指标/h3 p包括 P50 和 P99 延迟。实时对话场景对延迟敏感(目标 < 1s),批处理场景则可容忍较高延迟。系统需维护各模型端点的实时延迟监控数据。/p h3成本优化/h3 p不同模型的 Token 单价差异可达 50 倍以上。路由系统需在质量约束下最小化成本,或在预算约束下最大化质量。/p h3可用性与负载均衡/h3 p实时追踪各模型端点的错误率、超时率、当前排队深度,自动避开不可用或过载的端点。/p h3地域亲和性/h3 p根据用户 IP 就近选择部署节点,减少网络传输延迟。/p h3速率限制管理/h3 p跟踪 API 配额消耗情况,避免触发限流导致请求失败。/p h2四、技术路线分类/h2 h34.1 基于规则的路由(Rule-based Routing)/h3 p核心思路是设计决策树或规则引擎,基于 prompt 的可观测特征(长度、语言、是否含代码/JSON/函数调用)进行分桶路由。/p ul listrong优点:/strong 可解释性强、实现简单、延迟极低、易调试/li listrong缺点:/strong 规则需要人工维护,边界情况容易遗漏,难以自适应/li listrong代表系统:/strong 火山引擎 Auto Mode 一级分桶机制、Portkey 基于权重的路由/li listrong论文支撑:/strong Chen 等人(2023)在…
AgentScope 是阿里巴巴通义实验室开源的生产级 AI Agent 框架,截至 2026 年 7 月 GitHub 已获约 22.6k Stars、2.3k Forks。本文基于 AgentScope 2.0 实际源码(main 分支)进行深度架构分析。 !--more-- h2一、项目总览/h2 h31.1 基本信息/h3 table trth项目/thth详情/th/tr trtd全称/tdtdAgentScope(智能体框架)/td/tr trtd开发团队/tdtd阿里巴巴通义实验室/td/tr trtdGitHub/tdtdhttps://github.com/agentscope-ai/agentscope/td/tr trtd当前版本/tdtdAgentScope 2.0(2026年5月发布)/td/tr trtd许可协议/tdtdApache 2.0/td/tr trtdPython 版本/tdtd3.11+/td/tr trtd核心源码/tdtd约 14,500 行(22 个模块)/td/tr /table h31.2 设计哲学/h3 pAgentScope 2.0 的官方定位是 strong"production-ready, easy-to-use agent framework with essential abstractions"/strong。其核心设计原则:/p ul listrong先建模后扩展/strong:Msg(消息)、State(状态)、Event(事件)、Toolkit(工具)作为基础抽象/li listrong非入侵式架构/strong:不约束模型调用方式,让框架适配模型能力的增长/li listrong生产级安全/strong:沙箱隔离、权限控制、上下文压缩、会话恢复/li /ul h31.3 核心源码行数统计/h3 table trth模块/thth行数/thth文件数/th/tr trtdagent//tdtd2,807/tdtd4/td/tr trtdworkspace//tdtd3,143/tdtd9/td/tr trtdtool//tdtd2,262/tdtd10/td/tr trtdmiddleware//tdtd1,425/tdtd5/td/tr trtdpermission//tdtd999/tdtd6/td/tr trtdmessage//tdtd852/tdtd3/td/tr trtdevent//tdtd577/tdtd2/td/tr trtdmodel//tdtd880/tdtd5/td/tr trtdstrong总计/strong/tdtdstrong~14,465/strong/tdtdstrong~60/strong/td/tr /table h2二、Agent 架构:从继承体系到配置驱动/h2 pAgentScope 2.0 的智能体架构与 1.0 版本完全不同。strong2.0 移除了 AgentBase/ReActAgent/RealtimeAgent 的继承体系,改用单一 Agent 类 + 配置驱动模式/strong。/p precodefrom agentscope.agent import Agent # 统一 Agent 类 from agentscope.agent import ContextConfig # 上下文配置 from agentscope.agent import ModelConfig # 模型配置(含 Fallback) from agentscope.agent import ReActConfig # ReAct 循环配置/code/pre h3Agent 构造函数/h3 precodeclass Agent: def __init__( self, name: str, # Agent 标识 system_prompt: str, # 系统提示词 model: ChatModelBase, # 模型实例 toolkit: Toolkit | None = None, # 工具注册中心 middlewares: list[MiddlewareBase] | None = None, # 中间件链 state: AgentState | None = None, # Agent 状态 offloader: Offloader | None = None, # 上下文卸载器 model_config: ModelConfig | None = None, # 模型配置 context_config: ContextConfig | None = None, # 上下文压缩配置 react_config: ReActConfig | None = None, # ReAct 循环配置 )/code/pre h3核心方法/h3 table trth方法/thth说明/th/tr trtdreply_stream(inputs)/tdtd事件流式回复(核心入口,async generator)/td/tr trtdreply(inputs)/tdtd阻塞式回复(内部消费事件流)/td/tr trtdobserve(msgs)/tdtd接收外部观察消息/td/tr trtdcompress_context()/tdtd上下文压缩(token 超阈值触发)/td/tr /table h3_reply_impl 核心流程(源码 575-725 行)/h3 precode_reply_impl 入口 │ ├─ Step 1: 检查输入类型 │ ├─ UserConfirmResultEvent / ExternalExecutionResultEvent → 继续 │ └─ Msg / None → 新回复 │ ├─ Step 2: 处理事件或更新上下文 │ ├─ Step 3: ReAct 循环(while cur_iter max_iters) │ ├─ _check_next_action() → exit / reasoning │ ├─ reasoning → 上下文压缩 → _reasoning() │ │ ├─ 输出 Msg(无工具调用)→ 完成 │ │…
h1A2A (Agent-to-Agent) 协议详解/h1 A2A 是一个开放协议,让不同框架、不同厂商、不同服务器上运行的 AI Agent 能够互相通信和协作。当前版本 v1.0.0。 h2一、原始内容概述/h2 h31.1 什么是 A2A/h3 A2A(Agent-to-Agent,代理间通信协议)是一个开放协议,由 Google 贡献给 Linux Foundation 作为开源项目,Apache 2.0 许可。当前版本为 strongv1.0.0/strong(正式发布版)。 它的核心使命是:strong让不同框架、不同厂商、不同服务器上运行的 AI Agent 能够像 Agent 一样互相通信和协作——而不是作为对方的"工具"。/strong h31.2 核心问题/h3 A2A 解决的核心问题是:strong异构 AI Agent 系统之间如何实现互操作?/strong ul liAgent 可能用不同框架构建(ADK、LangGraph、BeeAI 等)/li liAgent 可能由不同公司运营(跨企业协作)/li liAgent 运行在不同服务器上(跨信任边界)/li liAgent 不能暴露内部状态、记忆或工具/li /ul A2A 的答案:定义一套通用语言,让 Agent 发现彼此、协商交互、安全协作,同时保持各自的不透明性。 h31.3 核心设计原则/h3 ol listrong简单/strong:复用成熟标准(HTTP、JSON-RPC 2.0、SSE)/li listrong企业就绪/strong:认证、授权、审计、追踪/li listrong异步优先/strong:长耗时任务和 HITL/li listrong模态无关/strong:文本、文件、结构化数据、音视频/li listrong透明执行/strong:不共享内部状态/li /ol h31.4 三层架构/h3 strongL1 — 数据模型层/strong:Task、Message、Part、Artifact、AgentCard、Extension strongL2 — 操作层/strong:Send Message、Send Streaming Message、Get Task、List Tasks、Cancel Task、Get Agent Card strongL3 — 协议绑定层/strong:JSON-RPC over HTTP(S)、gRPC、HTTP+JSON/REST h31.5 Agent 卡片(Agent Card)/h3 Agent Card 是 JSON 格式的"名片",包含身份信息、能力、技能、端点 URL、认证要求、租户标识。 h31.6 任务生命周期/h3 SUBMITTED → WORKING → COMPLETED / FAILED / CANCELED / REJECTED h31.7 三种交互模式/h3 strong① 同步请求/响应/strong:立即返回 Task 或 Message strong② 流式交互/strong:SSE 连接,实时推送中间结果 strong③ 异步推送通知/strong:webhook URL,服务器主动 POST h31.8 官方 SDK/h3 ul liPython:codepip install a2a-sdk/code/li liJavaScript:codenpm install @a2a-js/sdk/code/li liGo:codego get github.com/a2aproject/a2a-go/code/li liJava、.NET、Rust 均有 SDK/li /ul hr / h2二、使用场景举例/h2 h3场景 1:跨 Agent 任务委派/h3 主 Agent 通过 Agent Card 发现 Travel Agent 和 Hotel Agent,分别委派机票和酒店任务,子 Agent 各自处理返回结果。 h3场景 2:人机协同审批/h3 Agent A 提交报销审批 Task(状态 WORKING),等待主管审批(HITL),完成后 Task 变 COMPLETED。 h3场景 3:流式数据分析报告/h3 分析 Agent 流式返回中间结果,最终输出完整报告 Artifact,客户端实时看到分析进度。 h3场景 4:跨企业 Agent 协作/h3 企业 A 的供应链 Agent 查询企业 B 的库存 Agent——跨信任边界的协作典范。 h3场景 5:多框架异构 Agent 协同/h3 ADK + LangGraph + BeeAI 的 Agent 通过 A2A 在同一工作流中协作。 hr / h2三、最佳实践/h2 h3Agent 卡片设计/h3 ul li精确描述能力,不夸大/li li明确认证要求/li li版本管理/li /ul h3Task 管理/h3 ul li合理使用 historyLength/li li游标分页而非 offset/li licontextId 关联对话/li /ul h3错误处理/h3 ul li区分可重试和不可重试错误/li li流式中断后 Get Task 恢复/li li考虑幂等性/li /ul h3安全/h3 ul li始终验证 Agent Card/li li能力最小化/li li数据最小化/li li全程 HTTPS/li /ul hr / h2四、避坑指南/h2 ol listrong混淆 Send/Streaming Message/strong/li listrong忽视流式中断恢复/strong/li listrong不使用 contextId/strong/li listrongPush notification URL 不可达/strong/li listrong向终态 Task 发消息/strong:返回 UnsupportedOperationError/li listrong长轮询代替流式/推送/strong/li listrong忽略 historyLength 限制/strong/li listrong信任非…